
Baker团队用LigandMPNN实现基于原子环境的蛋白质序列设计
2025年3月,华盛顿大学戴维·贝克(DavidBaker)教授团队在国际顶级期刊NatureMethods(Q1)发表题为“Atomiccontext-conditionedproteinsequencedesignusingLigandMPNN”的研究文章。
本研究开发了一种名为LigandMPNN的深度学习方法,旨在解决当前蛋白质序列设计模型无法有效处理非蛋白质原子(如小分子、核苷酸和金属离子)的局限性。LigandMPNN明确模拟了生物分子系统中的所有非蛋白质成分,不仅能够生成蛋白质序列,还能预测侧链构象,从而允许对结合相互作用进行详细评估。相比于Rosetta和ProteinMPNN,该模型在涉及小分子、核苷酸和金属离子的天然骨架序列恢复率上表现出显著优势。此外,该方法已成功用于设计超过100种经过实验验证的小分子和DNA结合蛋白,并能显著提高现有设计的结合亲和力。论文获得了美国国防部、霍华德·休斯医学研究所(HHMI)及比尔及梅琳达·盖茨基金会等多家机构的资助。
主要结论
显著提升序列恢复率:在针对小分子、核苷酸和金属离子的残基设计中,LigandMPNN的天然骨架序列恢复率分别为63.3%、50.5%和77.5%,显著优于Rosetta(50.4%、35.2%、36.0%)和ProteinMPNN(50.5%、34.0%、40.6%)。
具备侧链构象预测能力:LigandMPNN不仅能输出序列,还能高精度地预测侧链扭转角(chiangles),其预测结果与晶体结构高度一致,便于评估具体的原子间相互作用。
实验验证与亲和力优化:该模型已成功设计出100多种具有高亲和力和高结构准确性(经X射线晶体结构验证)的小分子及DNA结合蛋白;用于重设计Rosetta生成的微弱结合体时,可将结合亲和力提高多达100倍。
挑战和展望
稀有元素处理的局限性:对于包含PDB数据库中罕见或不存在元素的化合物,使用LigandMPNN设计结合蛋白时需谨慎,必要时需将其映射为最接近的常见元素。
混合方法的潜力:在数据稀缺的情况下,将基于物理的方法(如Rosetta)与基于深度学习的方法(如LigandMPNN)相结合,可能为氨基酸和侧链优化问题提供更好的解决方案。
图文赏析
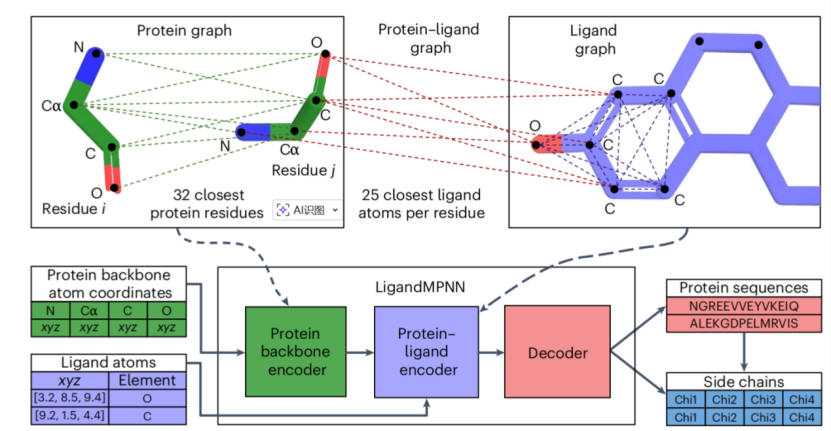
图1.LigandMPNN模型架构。该模型在三个不同的图上运行:(1)仅蛋白质图,编码残基间的距离;(2)配体内部图,编码原子类型和距离;(3)蛋白质-配体图,编码残基与最近配体原子之间的几何关系。
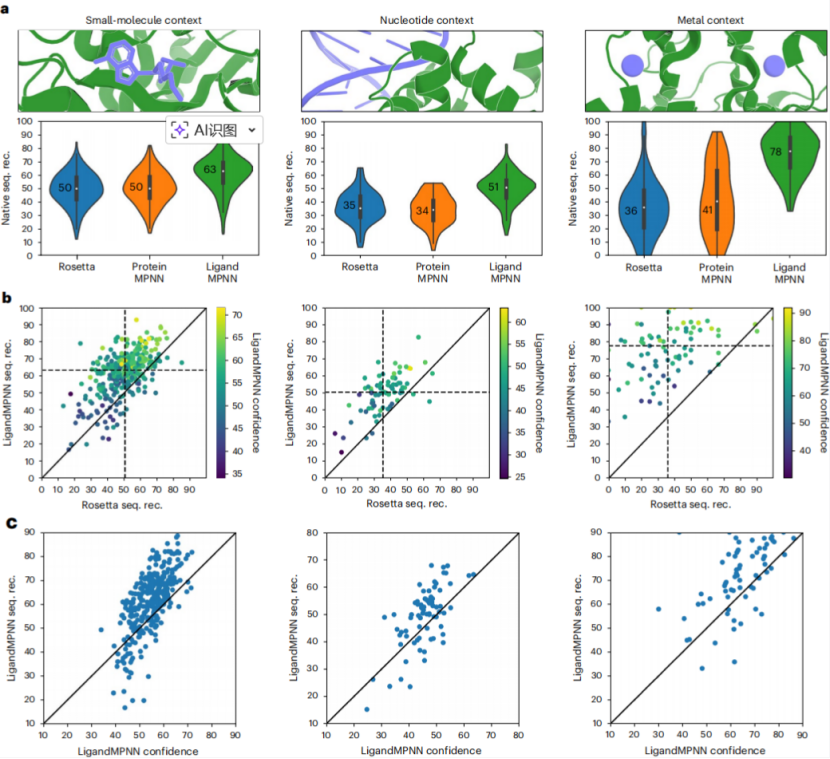
图2.LigandMPNN序列设计的计算机评估。(a)在小分子、核苷酸和金属离子周围,LigandMPNN的天然氨基酸序列恢复率均高于Rosetta和ProteinMPNN;(b)对大多数蛋白质而言,LigandMPNN在非蛋白质分子周围的序列恢复率优于Rosetta。
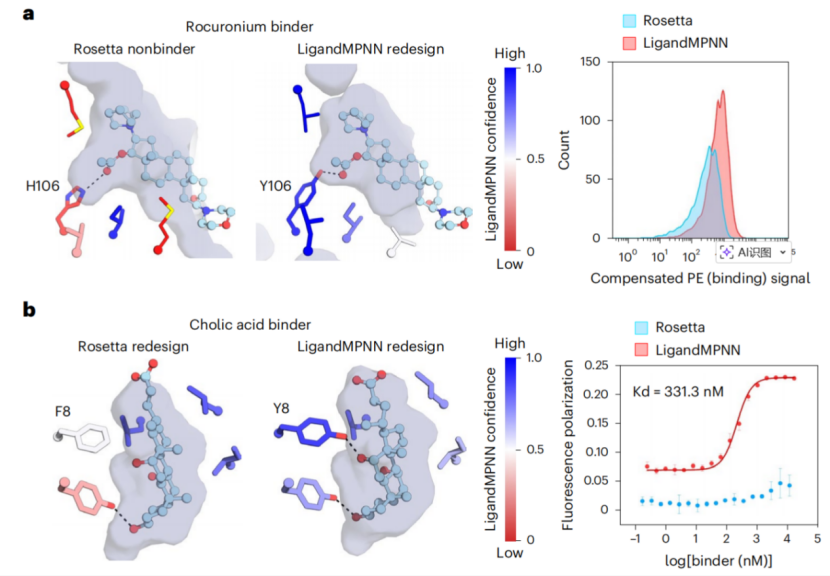
图3.利用LigandMPNN挽救Rosetta的小分子结合设计。针对肌肉松弛剂罗库溴铵(Rocuronium)和胆酸(Cholicacid),LigandMPNN对Rosetta设计的微弱或无结合能力的方案进行了重设计,成功引入了新的侧链-配体氢键相互作用,显著提高了结合亲和力。
DavidBaker
DavidBaker(通讯作者),华盛顿大学生物化学系教授,霍华德·休斯医学研究所(HHMI)研究员,华盛顿大学蛋白质设计研究所(InstituteforProteinDesign)所长。它是蛋白质设计领域的领军人物,长期致力于蛋白质结构预测和从头设计方法的研究。开发了著名的Rosetta蛋白质建模软件以及RoseTTAFold等深度学习工具。在Nature、Science等顶级期刊发表多篇高影响力论文,其研究成果在酶设计、药物开发、纳米材料等领域具有广泛应用前景。